TikTok-Videos transkribieren: Whisper-Transcriber selbst hosten
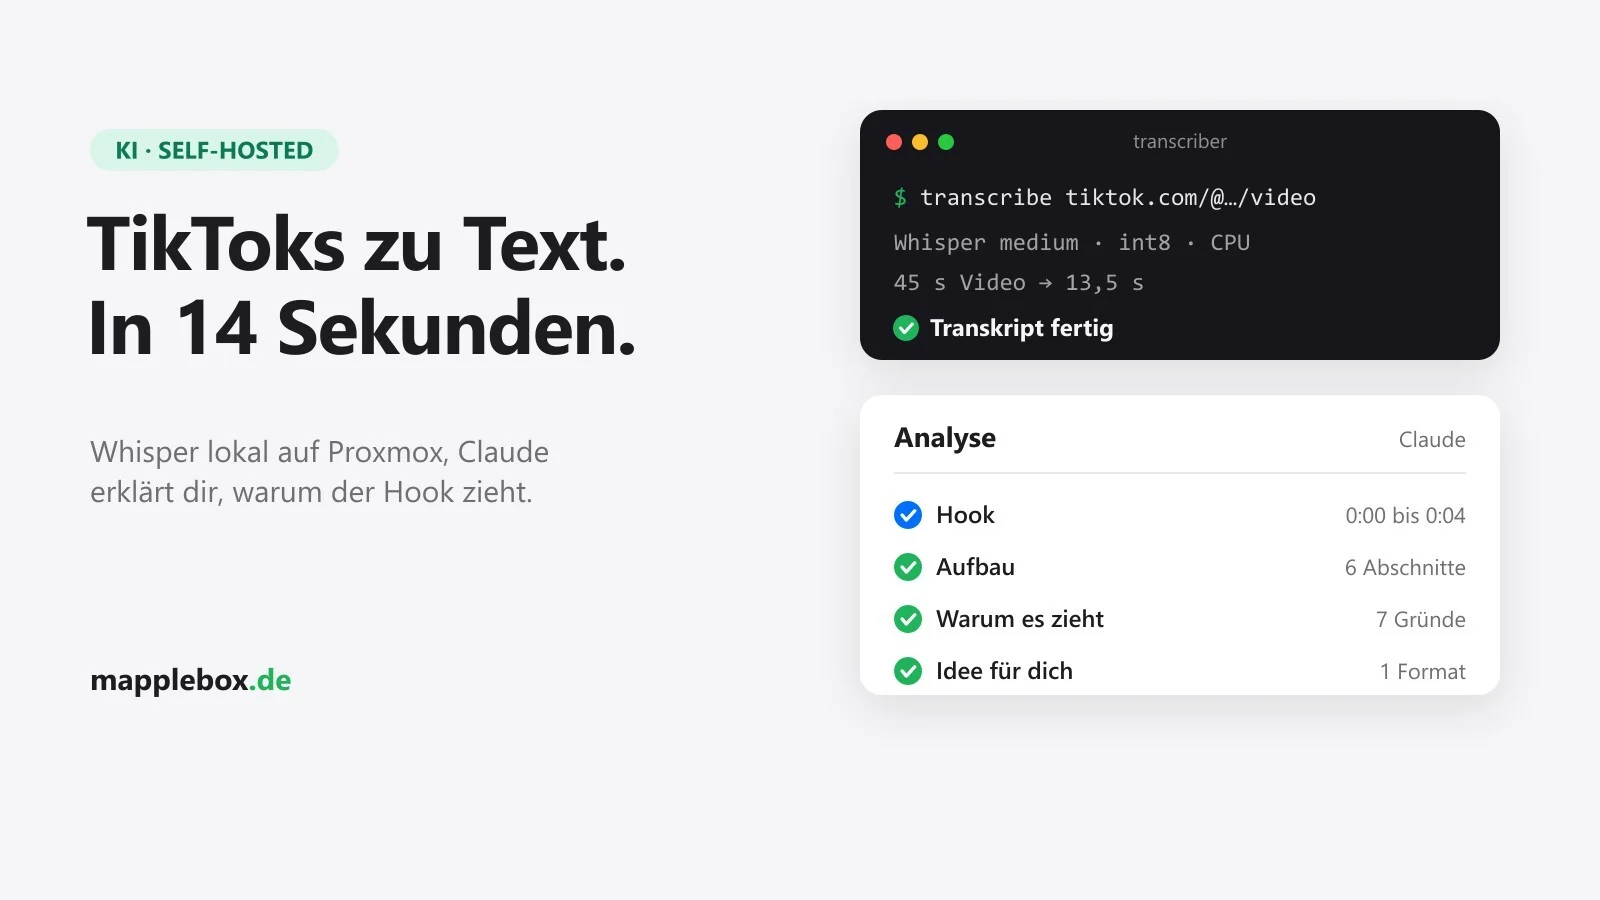
Mit einem selbst gehosteten Transcriber machst du aus TikToks, YouTube-Videos und Instagram-Reels in wenigen Sekunden Text. Du fügst einen Link ein und bekommst den gesprochenen Text zurück, auf Wunsch mit einer KI-Analyse dazu, warum das Video funktioniert. Die Transkription läuft komplett lokal auf deinem Server und kostet nichts, nur die optionale Analyse geht über die Anthropic API. Bei mir läuft das Setup in einem LXC auf einem Mini-PC mit AMD Ryzen 9, ohne Grafikkarte. Ein 45 Sekunden langes TikTok ist dort in 13,5 Sekunden fertig, und an einem Abend habe ich damit rund 30 Videos von Homelab- und KI-Creatorn durchgearbeitet.
Kurz erklärt
- yt-dlp (ein Kommandozeilen-Tool zum Herunterladen von Videos) holt die Tonspur, faster-whisper (eine schnelle Variante von OpenAIs Spracherkennung Whisper) schreibt sie auf deinem eigenen Server mit.
- Du bekommst eine kleine Web-Oberfläche, eine API und einen MCP-Server. MCP (Model Context Protocol) ist der Standard, über den Claude externe Tools benutzt. So kann Claude Code den Transcriber selbst aufrufen.
- Optional analysiert Claude Haiku das Transkript: Zusammenfassung, Hook, Aufbau mit Zeitstempeln, Call to Action, Übersetzung und eine Idee für deinen eigenen Content.
- Alles läuft in einem Docker-Container in einem unprivilegierten LXC auf Proxmox und ist nur aus dem Heimnetz und über Tailscale erreichbar. Ein LXC ist ein leichtgewichtiger Linux-Container. Unprivilegiert heißt, dass root im Container auf dem Proxmox-Host keine Root-Rechte hat.
- Du brauchst Proxmox, ein bisschen Erfahrung mit der Linux-Shell und für die Analyse einen API-Key von Anthropic.
Was du brauchst
- Einen Proxmox-Server. Mein Container hat 8 CPU-Kerne, 8 GB RAM und 24 GB Speicher. Eine GPU brauchst du nicht, Whisper läuft hier nur auf der CPU.
- Docker im LXC. Wie du das einrichtest, steht in Schritt 1.
- Einen Reverse Proxy wie Caddy, wenn du das Tool über einen Hostnamen mit HTTPS erreichen willst. Ein Reverse Proxy nimmt die Anfragen entgegen und reicht sie an den passenden Dienst weiter. Für den Zugriff von unterwegs nutze ich Tailscale, ein VPN, das deine Geräte in ein privates Netz hängt.
- Für die Analyse einen API-Key aus der Claude Console. Die Analyse verbraucht API-Guthaben, die Transkription selbst nicht.
- Für die Anbindung als Tool: Claude Code auf deinem Rechner.
Ich nutze den Transcriber nur für meine eigene Recherche. Das Herunterladen von Videos kann gegen die Nutzungsbedingungen der jeweiligen Plattform verstoßen, und Transkripte fremder Videos veröffentlichst du nicht als eigenen Content. Prüf selbst, was für dich in Ordnung ist.
So arbeitet der Transcriber
Du schickst einen Link an die App, yt-dlp lädt die Tonspur in einen temporären Ordner, und faster-whisper schreibt sie mit. Ich nutze das Modell medium mit int8, einer platzsparenden Rechengenauigkeit, die auf der CPU gut läuft. Ein VAD-Filter (Voice Activity Detection) überspringt Stellen ohne Sprache, und die Sprache des Videos erkennt Whisper automatisch. Auf meinem Ryzen 9 ist das grob viermal schneller als Echtzeit: Ein 208 Sekunden langes Video war nach 53,5 Sekunden fertig, Download und Transkription zusammen.
Ist ein Anthropic-API-Key gesetzt, schickt die App das fertige Transkript mit Zeitstempeln an Claude Haiku und speichert die Antwort als JSON, einem einfachen Textformat für strukturierte Daten. Es läuft immer nur ein Job gleichzeitig, weitere warten in einer Warteschlange. Jedes Ergebnis landet als .json und .txt im Datenordner, Videos über 15 Minuten lehnt die App ab.
Ein Detail bei TikTok war bei mir ein echter Bug. Die reine Audiospur, die TikTok anbietet, ist oft nur der angehängte Sound, also die Hintergrundmusik, und nicht die Stimme. Meine ersten TikTok-Transkripte kamen deshalb leer zurück. Der Code lädt bei TikTok darum das kleinste Video mit Ton herunter, denn darin steckt die echte Tonspur mit Stimme. Bei YouTube und Instagram nimmt er weiter die beste reine Audiospur.
Schritt 1: LXC mit Docker anlegen
Am schnellsten bekommst du einen LXC mit Docker über das Docker-Script der Proxmox Helper Scripts. Wie die Scripts funktionieren, erkläre ich in meinem Guide zu den Proxmox Helper Scripts. Du startest es in der Shell deines Proxmox-Hosts:
bash -c "$(curl -fsSL https://raw.githubusercontent.com/community-scripts/ProxmoxVE/main/ct/docker.sh)"Das Script stellt dir ein paar Fragen. Wähl als Betriebssystem Debian. Die Frage „Expose Docker TCP socket“ beantwortest du mit n, denn ein offener Docker-Socket wäre ein Zugang zu deinem ganzen Docker ohne Passwort. Ob Docker Compose mit installiert ist, prüfst du später in der Konsole des Containers mit docker compose version. Dort sollte eine Versionsnummer erscheinen.
Das Script legt den Container zum Zeitpunkt des Schreibens standardmäßig unprivilegiert mit 2 Kernen, 2 GB RAM und 4 GB Speicher an. Für Whisper ist das zu wenig. Du kannst die Werte in den erweiterten Einstellungen des Scripts ändern oder danach auf dem Proxmox-Host anpassen. 120 steht hier für die ID deines Containers:
pct set 120 --cores 8 --memory 8192 --features nesting=1,keyctl=1
pct resize 120 rootfs 24G
pct reboot 120
nesting und keyctl braucht Docker, damit es in einem unprivilegierten LXC läuft. pct resize ohne Pluszeichen setzt die Disk auf genau 24 GB, verkleinern geht damit nicht. Das Whisper-Modell allein ist laut Hugging Face, einer Plattform, auf der KI-Modelle zum Download liegen, rund 1,5 GB groß. Dazu kommen das Docker-Image, also die fertig gebaute Vorlage, aus der Docker den Container startet, und deine Transkripte.
Wenn du lieber einen normalen Debian-LXC nimmst und Docker selbst installierst, folg der offiziellen Anleitung für Debian. Die Features nesting und keyctl brauchst du dann genauso.
Schritt 2: Projektordner anlegen
Den kompletten Code gibt es auch fertig als Repository (ein Code-Projekt) auf GitHub: mapplebox/whisper-video-transcriber. Mit diesen Befehlen in der Konsole des Containers holst du ihn dir und sparst dir die Schritte 2 bis 5:
apt install -y git
git clone https://github.com/mapplebox/whisper-video-transcriber.git /opt/transcriber
cd /opt/transcriber
mkdir -p data
cp .env.example .env
chmod 600 .env
Danach trägst du in Schritt 6 nur noch deine Werte in die .env ein und machst mit Schritt 7 weiter. Willst du sehen, was in den Dateien steckt, oder etwas anpassen, gehst du die Schritte unten einfach durch. Der Code dort ist derselbe wie im Repository.
Öffne die Konsole des Containers (in Proxmox: Container auswählen, dann „Console“) und leg die Ordner an:
mkdir -p /opt/transcriber/app/static /opt/transcriber/data
cd /opt/transcriber
Am Ende sieht der Ordner so aus:
/opt/transcriber
├── Dockerfile
├── docker-compose.yml
├── requirements.txt
├── .env
├── .dockerignore   (optional)
├── app/
│   ├── main.py
│   └── static/
│       └── index.html
└── data/
Jede Datei legst du mit einem Editor an, zum Beispiel mit nano requirements.txt. Inhalt einfügen, mit Strg+O und Enter speichern, mit Strg+X schließen. So machst du es bei allen Dateien in den nächsten Schritten. Lange Dateien wie main.py in die Web-Konsole von Proxmox einzufügen ist mühsam. Läuft im Container SSH, geht es von deinem Rechner aus per SSH einfacher. Oder du speicherst die Datei auf dem Proxmox-Host und schiebst sie von dort in den Container: pct push 120 main.py /opt/transcriber/app/main.py.
Schritt 3: requirements.txt und Dockerfile
Die requirements.txt listet die Python-Pakete. Die meisten sind auf eine feste Version gepinnt, damit ein neuer Build nicht plötzlich anders läuft. yt-dlp ist bewusst nicht gepinnt: Plattformen wie TikTok ändern ständig etwas, und nur eine aktuelle Version kommt damit klar.
fastapi==0.143.1
uvicorn==0.54.0
pydantic==2.14.1
faster-whisper==1.2.1
av==13.1.0
mcp==1.30.0
requests
yt-dlp
Das Dockerfile baut das Image auf Basis von Python 3.12. ffmpeg braucht yt-dlp, um Audio und Video zu verarbeiten. Der Healthcheck fragt jede Minute /health ab, so siehst du in docker ps, ob die App läuft.
FROM python:3.12-slim
RUN apt-get update && apt-get install -y --no-install-recommends ffmpeg ca-certificates && rm -rf /var/lib/apt/lists/*
WORKDIR /srv
COPY requirements.txt .
RUN pip install --no-cache-dir -r requirements.txt
COPY app ./app
ENV DATA_DIR=/data PYTHONUNBUFFERED=1
EXPOSE 8000
HEALTHCHECK --interval=60s --timeout=5s CMD python -c "import urllib.request;urllib.request.urlopen('http://127.0.0.1:8000/health')"
CMD ["uvicorn", "app.main:app", "--host", "0.0.0.0", "--port", "8000"]
Für YouTube braucht yt-dlp zum Zeitpunkt des Schreibens zusätzlich eine JavaScript-Runtime, empfohlen wird Deno. Das Dockerfile oben bringt keine mit. Willst du YouTube-Links transkribieren, ergänzt du direkt unter der ersten Zeile COPY --from=denoland/deno:bin-2.9.7 /deno /usr/local/bin/deno und schreibst in der requirements.txt yt-dlp[default] statt yt-dlp. Die Versionsnummer im Image-Namen kannst du durch die aktuelle aus dem Docker Hub ersetzen.
Optional legst du noch eine .dockerignore an. Sie sorgt dafür, dass Docker beim Bauen den Datenordner und die Secrets gar nicht erst einliest. Das Dockerfile kopiert beides ohnehin nicht ins Image, die Datei ist also reine Hygiene:
data/
.env
Schritt 4: Die App (main.py)
Das Herzstück ist app/main.py, rund 320 Zeilen Python mit FastAPI, einem kleinen Web-Framework. Damit du weißt, was du da kopierst, hier die wichtigsten Teile:
- Oben liest die App ihre Einstellungen aus Umgebungsvariablen: Modell, Threads, maximale Videolänge, die Tokens und den API-Key. Erlaubt sind nur Links von TikTok, YouTube und Instagram.
download_audioholt die Tonspur mit yt-dlp, inklusive der TikTok-Sonderregel von oben.ANALYSIS_PROMPTundanalyze_jobschicken das Transkript an die Anthropic API und erwarten JSON zurück.run_jobundstart_joberledigen Download, Transkription und Analyse in einem Hintergrund-Thread und speichern das Ergebnis.- Die vier Funktionen mit
@mcp.tool()sind die Tools, die Claude später sieht:transcribe_video,list_transcripts,get_transcriptundanalyze_transcript. - Die Routen unter
/api/bedient die Web-Oberfläche. Ganz unten sorgt_McpAuthdafür, dass/mcpnur mit dem richtigen Bearer Token antwortet. Ein Bearer Token ist ein geheimer Schlüssel, den der Client im HTTP-Header mitschickt. Ist keinMCP_TOKENgesetzt, bleibt/mcpkomplett zu. Außerdem nimmt der MCP-Teil nur Anfragen an Hostnamen an, die inMCP_ALLOWED_HOSTSstehen, dazu mehr in Schritt 6.
Den Prompt für die Analyse habe ich auf mich zugeschnitten, er erwähnt mapplebox.de und fragt nach einer „Idee für MappleBox“. Pass den Text in ANALYSIS_PROMPT an deine eigenen Themen an. Die JSON-Schlüssel wie hook oder idee_mapplebox lässt du am besten stehen, weil die Web-Oberfläche genau diese Namen anzeigt. Änderst du sie, musst du sie in der index.html in der Liste sec ebenfalls ändern. Speicher den kompletten Block als app/main.py:
"""TikTok transcriber: paste a video link, get the spoken text.

yt-dlp fetches only the audio, faster-whisper transcribes it locally (no cloud). One job at a time, results are kept
as JSON + .txt in DATA_DIR. Internal tool, meant to sit behind a reverse proxy that only allows the LAN/tailnet.
"""
import contextlib
import json
import os
import urllib.request
import re
import tempfile
import threading
import time
import uuid
from pathlib import Path

from fastapi import FastAPI, Header, HTTPException
from fastapi.responses import FileResponse, PlainTextResponse
from fastapi.staticfiles import StaticFiles
from pydantic import BaseModel

DATA_DIR = Path(os.environ.get("DATA_DIR", "/data"))
MODEL_NAME = os.environ.get("WHISPER_MODEL", "medium")
COMPUTE_TYPE = os.environ.get("WHISPER_COMPUTE", "int8")
CPU_THREADS = int(os.environ.get("WHISPER_THREADS", "8"))
DEFAULT_LANG = os.environ.get("DEFAULT_LANGUAGE", "") or None  # empty = auto-detect
API_TOKEN = os.environ.get("API_TOKEN", "")  # optional: required as Bearer token for /api/* if set
MAX_SECONDS = int(os.environ.get("MAX_DURATION_SECONDS", "900"))
ANTHROPIC_KEY = os.environ.get("ANTHROPIC_API_KEY", "")
AI_MODEL = os.environ.get("AI_MODEL", "claude-haiku-5-5")
MCP_TOKEN = os.environ.get("MCP_TOKEN", "")  # required as Bearer token for /mcp
ALLOWED = re.compile(r"^https?://([a-z0-9-]+\.)*(tiktok\.com|youtube\.com|youtu\.be|instagram\.com)/", re.I)

DATA_DIR.mkdir(parents=True, exist_ok=True)
_model = None
_model_lock = threading.Lock()
_job_lock = threading.Lock()  # whisper on CPU: one transcription at a time
_jobs = {}  # id -> status dict (in memory, finished ones also on disk)


def model():
    global _model
    with _model_lock:
        if _model is None:
            from faster_whisper import WhisperModel
            _model = WhisperModel(MODEL_NAME, device="cpu", compute_type=COMPUTE_TYPE, cpu_threads=CPU_THREADS,
                                  download_root=str(DATA_DIR / "models"))
        return _model


def check_token(authorization):
    if API_TOKEN and authorization != f"Bearer {API_TOKEN}":
        raise HTTPException(401, "missing or wrong token")


def download_audio(url, workdir):
    import yt_dlp
    # TikTok's audio-only format is the attached "sound" (often just the music), not the
    # video's own mix, so take the smallest muxed video there; it carries the real voice track.
    fmt = "worst[vcodec!=none][acodec!=none]/best" if "tiktok.com" in url else "bestaudio/best"
    opts = {"format": fmt, "outtmpl": str(Path(workdir) / "audio.%(ext)s"), "quiet": True,
            "noplaylist": True, "no_warnings": True, "match_filter": yt_dlp.utils.match_filter_func(
                f"duration <= {MAX_SECONDS}")}
    with yt_dlp.YoutubeDL(opts) as ydl:
        info = ydl.extract_info(url, download=True)
    files = list(Path(workdir).glob("audio.*"))
    if not files:
        raise RuntimeError("no audio downloaded (too long, private or removed?)")
    return files[0], info


ANALYSIS_PROMPT = """Du analysierst ein Kurzvideo (TikTok, Reel oder Short) für einen deutschen Creator, der Guides zu
Homelab, Streaming-Setups, Gaming und Tech macht (mapplebox.de). Antworte nur mit JSON in genau diesem Format:
{"zusammenfassung": "2 bis 3 Sätze, worum es geht",
 "hook": "was in den ersten 3 Sekunden passiert oder gesagt wird und warum es zum Weiterschauen bringt",
 "aufbau": ["Abschnitt 1 mit Zeitangabe", "..."],
 "warum_es_funktioniert": ["Grund 1", "..."],
 "cta": "Call to Action im Video, oder leer",
 "uebersetzung_de": "deutsche Übersetzung des Transkripts, nur wenn das Video nicht auf Deutsch ist, sonst leer",
 "idee_mapplebox": "eine konkrete Idee, wie man das Format für ein eigenes MappleBox-Thema nutzen könnte"}
Bleib bei dem, was im Transkript und in den Metadaten steht. Erfinde keine Inhalte."""


def analyze_job(job):
    if not ANTHROPIC_KEY:
        raise RuntimeError("no ANTHROPIC_API_KEY configured")
    lines = "\n".join(f"[{s['start']:.0f}s] {s['text']}" for s in job.get("segments", []))
    user = (f"Titel: {job.get('title', '')}\nKanal: {job.get('uploader', '')}\nLänge: {job.get('duration')} s\n"
            f"Views: {job.get('views')} / Likes: {job.get('likes')}\n"
            f"Sprache: {job.get('language')}\n\nTranskript mit Zeitstempeln:\n{lines or '(kein gesprochener Text)'}")
    body = json.dumps({"model": AI_MODEL, "max_tokens": 8000, "system": ANALYSIS_PROMPT,
                       "messages": [{"role": "user", "content": user}]}).encode()
    req = urllib.request.Request("https://api.anthropic.com/v1/messages", data=body, method="POST", headers={
        "x-api-key": ANTHROPIC_KEY, "anthropic-version": "2023-06-01", "content-type": "application/json"})
    with urllib.request.urlopen(req, timeout=120) as r:
        resp = json.loads(r.read())
    text = "".join(c.get("text", "") for c in resp.get("content", []) if c.get("type") == "text").strip()
    m = re.search(r"\{.*\}", text, re.S)
    try:
        return json.loads(m.group(0)) if m else {"zusammenfassung": text}
    except ValueError:
        return {"zusammenfassung": text}


def save(job):
    (DATA_DIR / f"{job['id']}.json").write_text(json.dumps(job, ensure_ascii=False, indent=1), encoding="utf-8")


def run_job(job_id, url, language, analyze=False):
    job = _jobs[job_id]
    with _job_lock:
        job["status"] = "running"
        started = time.time()
        try:
            with tempfile.TemporaryDirectory() as tmp:
                audio, info = download_audio(url, tmp)
                segments, meta = model().transcribe(str(audio), language=language or DEFAULT_LANG,
                                                    vad_filter=True, beam_size=5)
                segs = [{"start": round(s.start, 2), "end": round(s.end, 2), "text": s.text.strip()} for s in segments]
            text = " ".join(s["text"] for s in segs).strip()
            job.update(status="done", text=text, segments=segs, language=meta.language,
                       title=info.get("title") or "", uploader=info.get("uploader") or "",
                       duration=info.get("duration"), views=info.get("view_count"), likes=info.get("like_count"),
                       comments=info.get("comment_count"), upload_date=info.get("upload_date"), seconds=round(time.time() - started, 1))
        except Exception as e:  # noqa: BLE001 - report every failure to the UI
            job.update(status="error", error=str(e)[:500])
        if job["status"] == "done" and analyze and ANTHROPIC_KEY:
            job["status"] = "analyzing"
            try:
                job["analysis"] = analyze_job(job)
            except Exception as e:  # noqa: BLE001 - transcript stays usable without analysis
                job["analysis_error"] = str(e)[:300]
            job["status"] = "done"
        job["finished"] = time.strftime("%Y-%m-%d %H:%M:%S")
        save(job)
        if job["status"] == "done":
            (DATA_DIR / f"{job_id}.txt").write_text(job["text"] + "\n", encoding="utf-8")


class TranscribeIn(BaseModel):
    url: str
    language: str | None = None
    wait: bool = False
    analyze: bool = True


def start_job(url, language=None, analyze=True, wait=False):
    url = url.strip()
    if not ALLOWED.match(url):
        raise ValueError("only TikTok, YouTube or Instagram links")
    job_id = uuid.uuid4().hex[:12]
    _jobs[job_id] = {"id": job_id, "url": url, "status": "queued", "created": time.strftime("%Y-%m-%d %H:%M:%S")}
    t = threading.Thread(target=run_job, args=(job_id, url, language, analyze), daemon=True)
    t.start()
    if wait:
        t.join()
    return _jobs[job_id]


# ---------- MCP (streamable HTTP at /mcp, Bearer MCP_TOKEN) ----------
from mcp.server.fastmcp import FastMCP  # noqa: E402
from mcp.server.transport_security import TransportSecuritySettings  # noqa: E402

# The SDK rejects requests whose Host header isn't allowed (DNS rebinding protection). Behind a reverse proxy the
# Host is the public name, so list every name you reach /mcp by in MCP_ALLOWED_HOSTS (comma-separated, host:port ok).
_hosts = ["127.0.0.1:*", "localhost:*"] + [h.strip() for h in os.environ.get("MCP_ALLOWED_HOSTS", "").split(",") if h.strip()]
mcp = FastMCP("transcriber", stateless_http=True, json_response=True, streamable_http_path="/mcp",
              transport_security=TransportSecuritySettings(enable_dns_rebinding_protection=True, allowed_hosts=_hosts))


@mcp.tool()
def transcribe_video(url: str, language: str | None = None, analyze: bool = True) -> dict:
    """Transcribe a TikTok, YouTube or Instagram video (speech to text with local Whisper) and optionally analyse it
    with Claude: summary, hook, structure, why it works, CTA, German translation, an idea for MappleBox. Blocks until
    done: short clips take seconds, long videos a few minutes. language: ISO code like "de", or None to auto-detect."""
    j = start_job(url, language, analyze, wait=True)
    return {k: j.get(k) for k in ("id", "status", "error", "title", "uploader", "duration", "views", "likes", "language", "text",
                                  "analysis", "analysis_error")}


@mcp.tool()
def list_transcripts(limit: int = 20) -> list:
    """List recent transcripts (id, title, uploader, url, date)."""
    return _list(limit)["done"]


@mcp.tool()
def get_transcript(transcript_id: str) -> dict:
    """Get one transcript with text, timestamps and analysis by id."""
    return load(transcript_id)


@mcp.tool()
def analyze_transcript(transcript_id: str) -> dict:
    """Run (or re-run) the Claude analysis for an existing transcript."""
    return _analyze(transcript_id)


_mcp_app = mcp.streamable_http_app()


@contextlib.asynccontextmanager
async def lifespan(_app):
    async with mcp.session_manager.run():
        yield


app = FastAPI(title="Transcriber", lifespan=lifespan)


@app.post("/api/transcribe")
def transcribe(body: TranscribeIn, authorization: str | None = Header(default=None)):
    check_token(authorization)
    try:
        return start_job(body.url, body.language, body.analyze, body.wait)
    except ValueError as e:
        raise HTTPException(400, str(e))


def load(job_id):
    if job_id in _jobs:
        return _jobs[job_id]
    f = DATA_DIR / f"{re.sub(r'[^a-f0-9]', '', job_id)}.json"
    if not f.exists():
        raise HTTPException(404, "not found")
    return json.loads(f.read_text(encoding="utf-8"))


@app.get("/api/transcripts/{job_id}.txt", response_class=PlainTextResponse)
def get_txt(job_id: str, authorization: str | None = Header(default=None)):
    check_token(authorization)
    j = load(job_id)
    if j.get("status") != "done":
        raise HTTPException(409, j.get("status"))
    return j["text"]


@app.get("/api/transcripts/{job_id}")
def get_job(job_id: str, authorization: str | None = Header(default=None)):
    check_token(authorization)
    return load(job_id)


def _list(limit):
    done = []
    for f in sorted(DATA_DIR.glob("*.json"), key=lambda p: p.stat().st_mtime, reverse=True)[:limit]:
        try:
            j = json.loads(f.read_text(encoding="utf-8"))
            done.append({k: j.get(k) for k in ("id", "url", "status", "title", "uploader", "finished", "language")})
        except ValueError:
            pass
    running = [{k: j.get(k) for k in ("id", "url", "status", "created")} for j in _jobs.values()
               if j["status"] in ("queued", "running", "analyzing")]
    return {"running": running, "done": done}


def _analyze(job_id):
    j = load(job_id)
    if j.get("status") != "done":
        raise HTTPException(409, j.get("status"))
    try:
        j["analysis"] = analyze_job(j)
        j.pop("analysis_error", None)
    except Exception as e:  # noqa: BLE001
        j["analysis_error"] = str(e)[:300]
    save(j)
    if j["id"] in _jobs:
        _jobs[j["id"]] = j
    return j


@app.get("/api/transcripts")
def list_jobs(limit: int = 30, authorization: str | None = Header(default=None)):
    check_token(authorization)
    return _list(limit)


@app.post("/api/transcripts/{job_id}/analyze")
def analyze(job_id: str, authorization: str | None = Header(default=None)):
    check_token(authorization)
    return _analyze(job_id)


@app.get("/health")
def health():
    return {"ok": True, "model": MODEL_NAME, "loaded": _model is not None, "analysis": bool(ANTHROPIC_KEY),
            "mcp": bool(MCP_TOKEN)}


@app.get("/")
def index():
    return FileResponse(Path(__file__).parent / "static" / "index.html")


app.mount("/static", StaticFiles(directory=Path(__file__).parent / "static"), name="static")


class _McpAuth:
    """Serves only /mcp; requires Authorization: Bearer MCP_TOKEN (closed if no token is set)."""

    def __init__(self, inner):
        self.inner = inner

    async def __call__(self, scope, receive, send):
        if scope["type"] == "http":
            status = None
            if not scope["path"].startswith("/mcp"):
                status, msg = 404, b"not found"
            else:
                auth = dict(scope.get("headers", [])).get(b"authorization", b"").decode()
                if not MCP_TOKEN or auth != f"Bearer {MCP_TOKEN}":
                    status, msg = 401, b"unauthorized"
            if status:
                await send({"type": "http.response.start", "status": status,
                            "headers": [(b"content-type", b"text/plain")]})
                await send({"type": "http.response.body", "body": msg})
                return
        await self.inner(scope, receive, send)


app.mount("/", _McpAuth(_mcp_app))
Schritt 5: Die Web-Oberfläche (index.html)
Die Oberfläche ist eine einzelne HTML-Datei ohne Build-Schritt. Sie hat ein Feld für den Link, eine Sprachauswahl, einen Haken für die Analyse, das Transkript mit Kopieren- und Download-Button und eine Liste der letzten Transkripte. Während ein Job läuft, fragt sie alle zwei Sekunden den Status ab. Der Kopieren-Button funktioniert nur, wenn du die Seite über HTTPS aufrufst, weil Browser die Zwischenablage sonst sperren. Ohne HTTPS markierst du den Text einfach von Hand. Speicher sie als app/static/index.html:
<!doctype html>
<html lang="de">
<head>
<meta charset="utf-8">
<meta name="viewport" content="width=device-width, initial-scale=1">
<title>Transcriber</title>
<style>
:root{--bg:#f5f5f7;--card:#fff;--ink:#1d1d1f;--muted:#6e6e73;--line:#e8e8ed;--acc:#10b981;--err:#e5383b}
@media (prefers-color-scheme:dark){:root{--bg:#121417;--card:#1b1f24;--ink:#f1f5f9;--muted:#94a3b8;--line:#2d333b}}
*{box-sizing:border-box}
body{margin:0;background:var(--bg);color:var(--ink);font:16px/1.5 system-ui,-apple-system,"Segoe UI",sans-serif}
main{max-width:760px;margin:0 auto;padding:40px 16px}
h1{font-size:34px;letter-spacing:-.02em;margin:0 0 4px}
p.sub{color:var(--muted);margin:0 0 24px}
.card{background:var(--card);border-radius:20px;padding:20px;box-shadow:0 18px 40px -24px rgba(0,0,0,.25);margin-bottom:18px}
form{display:flex;gap:10px;flex-wrap:wrap}
input,select{flex:1 1 300px;padding:.8rem 1rem;border-radius:12px;border:1px solid var(--line);background:var(--bg);color:var(--ink);font:inherit}
select{flex:0 0 auto}
button{padding:.8rem 1.4rem;border:0;border-radius:999px;background:var(--acc);color:#fff;font-weight:700;cursor:pointer}
button.ghost{background:transparent;color:var(--ink);border:1px solid var(--line);padding:.45rem .9rem;font-weight:600}
button:disabled{opacity:.5;cursor:wait}
.status{color:var(--muted);font-size:.9rem;margin-top:10px;min-height:1.4em}
.err{color:var(--err)}
textarea{width:100%;min-height:220px;border-radius:12px;border:1px solid var(--line);background:var(--bg);color:var(--ink);padding:12px;font:inherit;resize:vertical}
.row{display:flex;gap:8px;align-items:center;justify-content:space-between;margin-bottom:10px;flex-wrap:wrap}
.meta{color:var(--muted);font-size:.85rem}
ul{list-style:none;margin:0;padding:0}
li{padding:10px 0;border-top:1px solid var(--line);display:flex;justify-content:space-between;gap:12px}
li:first-child{border-top:0}
li a{color:var(--ink);text-decoration:none;font-weight:600;cursor:pointer}
li a:hover{color:var(--acc)}
label.chk{display:flex;align-items:center;gap:6px;color:var(--muted);font-size:.9rem;flex:0 0 auto}
#ana h3{font-size:.8rem;text-transform:uppercase;letter-spacing:.06em;color:var(--muted);margin:16px 0 4px}
#ana h3:first-child{margin-top:0}
#ana p,#ana ul{margin:0}
#ana ul{list-style:disc;padding-left:1.2em}
#ana li{display:list-item;border:0;padding:2px 0}
</style>
</head>
<body>
<main>
<h1>Transcriber</h1>
<p class="sub">TikTok-, YouTube- oder Instagram-Link rein, gesprochener Text raus. Läuft komplett lokal.</p>
<div class="card">
<form id="f">
<input id="url" type="url" placeholder="https://www.tiktok.com/@…/video/…" required>
<select id="lang"><option value="">Sprache: automatisch</option><option value="de">Deutsch</option><option value="en">Englisch</option><option value="fr">Französisch</option></select>
<label class="chk"><input type="checkbox" id="an" checked> Mit Claude analysieren</label>
<button id="go">Transkribieren</button>
</form>
<div class="status" id="st"></div>
</div>
<div class="card" id="out" hidden>
<div class="row"><div><strong id="title"></strong><div class="meta" id="meta"></div></div>
<div><button class="ghost" id="copy">Kopieren</button> <button class="ghost" id="dl">.txt</button></div></div>
<textarea id="text" readonly></textarea>
</div>
<div class="card" id="anacard" hidden>
<div class="row"><strong>Analyse</strong><button class="ghost" id="reana">Neu analysieren</button></div>
<div id="ana"></div>
</div>
<div class="card"><div class="row"><strong>Letzte Transkripte</strong><button class="ghost" id="reload">Aktualisieren</button></div><ul id="list"></ul></div>
</main>
<script>
const $ = (id) => document.getElementById(id);
let current = null;
async function api(path, opts) { const r = await fetch(path, opts); if (!r.ok) throw new Error((await r.json().catch(() => ({}))).detail || r.status); return r.json(); }
function show(j) {
current = j; $("out").hidden = false;
$("title").textContent = j.title || j.url;
$("meta").textContent = [j.uploader, j.language && ("Sprache " + j.language), j.duration && (Math.round(j.duration) + " s Video"), j.seconds && (j.seconds + " s gebraucht")].filter(Boolean).join(" · ");
$("text").value = j.text || "";
const a = j.analysis, box = $("ana");
$("anacard").hidden = !a && !j.analysis_error;
box.innerHTML = "";
if (j.analysis_error) { box.innerHTML = '<p class="err">' + esc(j.analysis_error) + "</p>"; return; }
if (!a) return;
const sec = [["zusammenfassung", "Zusammenfassung"], ["hook", "Hook"], ["aufbau", "Aufbau"],
["warum_es_funktioniert", "Warum es funktioniert"], ["cta", "Call to Action"], ["uebersetzung_de", "Deutsche Übersetzung"],
["idee_mapplebox", "Idee für MappleBox"]];
for (const [k, label] of sec) {
const v = a[k]; if (!v || (Array.isArray(v) && !v.length)) continue;
const h = document.createElement("h3"); h.textContent = label; box.append(h);
if (Array.isArray(v)) { const ul = document.createElement("ul"); v.forEach((x) => { const li = document.createElement("li"); li.textContent = x; ul.append(li); }); box.append(ul); }
else { const p = document.createElement("p"); p.textContent = v; box.append(p); }
}
}
function esc(t) { return String(t).replace(/[&<>]/g, (c) => ({ "&": "&", "<": "<", ">": ">" }[c])); }
async function poll(id) {
for (;;) {
const j = await api("/api/transcripts/" + id);
if (j.status === "done") { $("st").textContent = "Fertig."; show(j); break; }
if (j.status === "error") { $("st").innerHTML = '<span class="err">Fehler: ' + j.error.replace(/</g, "<") + "</span>"; break; }
$("st").textContent = j.status === "queued" ? "In der Warteschlange …" : j.status === "analyzing" ? "Claude analysiert …" : "Lade Audio und transkribiere … (der erste Lauf lädt einmalig das Whisper-Modell)";
await new Promise((r) => setTimeout(r, 2000));
}
$("go").disabled = false; loadList();
}
$("f").onsubmit = async (e) => {
e.preventDefault(); $("go").disabled = true; $("st").textContent = "Starte …";
try { const j = await api("/api/transcribe", { method: "POST", headers: { "Content-Type": "application/json" }, body: JSON.stringify({ url: $("url").value, language: $("lang").value || null, analyze: $("an").checked }) }); poll(j.id); }
catch (err) { $("st").innerHTML = '<span class="err">' + err.message + "</span>"; $("go").disabled = false; }
};
$("reana").onclick = async () => { if (!current) return; $("reana").disabled = true; $("ana").innerHTML = "<p>Claude analysiert …</p>";
try { show(await api("/api/transcripts/" + current.id + "/analyze", { method: "POST" })); } finally { $("reana").disabled = false; } };
$("copy").onclick = () => navigator.clipboard.writeText($("text").value);
$("dl").onclick = () => { if (current) location.href = "/api/transcripts/" + current.id + ".txt"; };
async function loadList() {
const d = await api("/api/transcripts");
$("list").innerHTML = "";
[...d.running, ...d.done].forEach((j) => {
const li = document.createElement("li"), a = document.createElement("a"), m = document.createElement("span");
a.textContent = j.title || j.url; m.className = "meta"; m.textContent = j.status === "done" ? (j.finished || "") : j.status;
a.onclick = async () => { const full = await api("/api/transcripts/" + j.id); if (full.status === "done") show(full); else poll(j.id); };
li.append(a, m); $("list").append(li);
});
}
$("reload").onclick = loadList; loadList();
</script>
</body>
</html>Schritt 6: docker-compose.yml und Secrets
Die docker-compose.yml beschreibt, wie der Container gestartet wird. Unter environment stellst du Whisper ein. small ist schneller, large-v3 am genauesten, braucht aber deutlich mehr Rechenzeit und RAM. WHISPER_THREADS setzt du auf die Zahl der Kerne deines LXC. Lässt du DEFAULT_LANGUAGE leer, erkennt Whisper die Sprache selbst. Der Ordner ./data enthält die Transkripte und das heruntergeladene Modell, dadurch überleben beide einen Neubau des Containers.
services:
  transcriber:
    build: .
    container_name: transcriber
    restart: unless-stopped
    env_file: .env             # ANTHROPIC_API_KEY, MCP_TOKEN, MCP_ALLOWED_HOSTS, optional API_TOKEN (mode 600, not in git)
    ports:
      - "0.0.0.0:8000:8000"   # IPv4 only: the DOCKER-USER firewall rule does not cover IPv6
    environment:
      WHISPER_MODEL: medium       # small = faster, large-v3 = most accurate
      WHISPER_COMPUTE: int8
      WHISPER_THREADS: "8"
      DEFAULT_LANGUAGE: ""        # empty = auto-detect, e.g. "de"
      MAX_DURATION_SECONDS: "900"
    volumes:
      - ./data:/data
Die Secrets kommen in eine eigene .env, die nur root lesen darf. Erzeug zuerst einen langen Zufallswert für den MCP-Token:
cd /opt/transcriber
umask 077
openssl rand -hex 32
nano .env
In die .env schreibst du deinen API-Key aus der Claude Console und den Zufallswert von eben. Ohne ANTHROPIC_API_KEY läuft die Transkription trotzdem, nur die Analyse fällt weg:
ANTHROPIC_API_KEY=dein-api-key
MCP_TOKEN=dein-zufallswert
MCP_ALLOWED_HOSTS=transcribe.example.com
In MCP_ALLOWED_HOSTS trägst du jeden Namen ein, unter dem du /mcp aufrufst, mehrere durch Komma getrennt. Für den Test ohne Caddy aus Schritt 9 kommt zum Beispiel 192.168.1.50:8000 dazu. Der MCP-Teil lehnt alle anderen Hostnamen ab und schützt dich so vor DNS-Rebinding, einem Trick, bei dem eine fremde Webseite deinen Browser auf Dienste in deinem Heimnetz umlenkt.
Danach setzt du die Rechte zur Sicherheit noch mal fest. ls -l .env sollte -rw------- zeigen:
chmod 600 .env
ls -l .env
Wenn du den Ordner mit Git versionierst, trag .env und data/ in die .gitignore ein. Und kopier den API-Key nicht in einen Chat mit Claude, auch wenn es bequem wäre. Warum, erkläre ich im Guide zu sicheren MCP-Servern.
Es gibt noch eine dritte, optionale Variable: API_TOKEN. Ist sie gesetzt, verlangt die App den Token bei allen /api/-Routen. Die Web-Oberfläche schickt aber keinen Token mit und funktioniert dann nicht mehr. Ich lasse API_TOKEN deshalb leer und schütze den Zugriff über die Firewall und Caddy (Schritt 8 und 9). Setz sie nur, wenn du den Transcriber ausschließlich per API oder MCP nutzt.
Schritt 7: Bauen und starten
Im Projektordner baust und startest du den Container mit einem Befehl. Der erste Build dauert ein paar Minuten, weil Docker Python-Pakete und ffmpeg installiert:
cd /opt/transcriber
docker compose up -d --build
docker compose logs -f
In den Logs sollte uvicorn, der Webserver, der die Python-App ausliefert, melden, dass es auf Port 8000 läuft. Mit Strg+C verlässt du die Log-Ansicht, der Container läuft weiter. Das Whisper-Modell lädt die App erst beim ersten Job von Hugging Face herunter und legt es unter data/models ab. Der erste Job dauert deshalb länger, alle weiteren nutzen das gespeicherte Modell.
Schritt 8: Port 8000 abriegeln
Diesen Schritt brauchst du auf jeden Fall. Docker veröffentlicht Port 8000 im ganzen Heimnetz, und ohne API_TOKEN verlangt die API unter /api/ keine Anmeldung. Jedes Gerät in deinem LAN könnte also Jobs starten und deine Transkripte lesen. Erlaub den Port deshalb nur für Caddy.
Läuft Caddy auf einem anderen Rechner oder in einem anderen Container, setzt du im LXC eine Regel für iptables, die Firewall im Linux-Kernel. Docker-Ports laufen an der normalen INPUT-Chain vorbei, deshalb gehört die Regel in die Chain DOCKER-USER. <caddy-ip> ist die IP deines Caddy-Servers:
iptables -I DOCKER-USER -i eth0 -p tcp --dport 8000 ! -s <caddy-ip> -j DROP-i eth0 sorgt dafür, dass die Regel nur Pakete trifft, die von außen in den LXC kommen, und den Verkehr innerhalb von Docker in Ruhe lässt. Regeln aus iptables sind nach einem Neustart weg. Unter Debian speicherst du sie mit dem Paket iptables-persistent, das sie beim Booten wieder lädt:
apt install iptables-persistent
iptables-save > /etc/iptables/rules.v4
Die gespeicherte Datei enthält auch die Regeln, die Docker selbst anlegt. Prüf deshalb nach dem ersten Neustart mit iptables -L DOCKER-USER -n -v --line-numbers, ob deine Regel genau einmal in der Chain steht. Meldet iptables ein fehlendes Kernel-Modul, findest du die Lösung im Guide zu sicheren MCP-Servern.
Läuft Caddy im selben LXC wie der Transcriber, brauchst du keine Firewall-Regel. Dann bindest du den Port nur an 127.0.0.1, eine Adresse, die nur innerhalb des Containers erreichbar ist. Ändere dazu in der docker-compose.yml die Zeile unter ports in - "127.0.0.1:8000:8000" und starte mit docker compose up -d neu. Das ist die einzige Abweichung von der Datei oben. In Caddy schreibst du dann reverse_proxy 127.0.0.1:8000.
Schritt 9: Zugriff nur aus dem Heimnetz und über Tailscale
Der Transcriber gehört nicht ins offene Internet. Er lädt Dateien herunter, verbraucht Rechenzeit und kann API-Guthaben kosten. Ich lasse ihn deshalb nur über Caddy erreichen, und Caddy lässt nur das Heimnetz und Tailscale durch. Angenommen, dein LXC hat die IP 192.168.1.50, dann sieht der Block im Caddyfile so aus:
transcribe.example.com {
	@extern not remote_ip 192.168.1.0/24 100.64.0.0/10
	respond @extern 403

	reverse_proxy 192.168.1.50:8000
}
192.168.1.0/24 ersetzt du durch dein eigenes Subnetz, also den Adressbereich deines Heimnetzes. /24 steht hier für alle Adressen von 192.168.1.0 bis 192.168.1.255. 100.64.0.0/10 ist der Adressbereich von Tailscale. Danach lädst du Caddy neu, etwa mit systemctl reload caddy. Für einen internen Hostnamen klappt die normale Zertifikats-Challenge von Let’s Encrypt nicht, weil der Name aus dem Internet nicht erreichbar ist. Wie du das mit DNS-Challenge oder tls internal löst, steht ausführlich im Guide zu sicheren MCP-Servern.
Damit transcribe.example.com überhaupt bei Caddy ankommt, brauchst du einen lokalen DNS-Eintrag, zum Beispiel in deinem Router oder in Pi-hole. Der Name zeigt auf die IP des Rechners, auf dem Caddy läuft. Von unterwegs erreichst du den Transcriber nur über dein Tailnet, also das private Netz von Tailscale. Dafür muss entweder der Caddy-Host selbst in Tailscale hängen oder ein Subnet Router dein Heimnetz ins Tailnet bringen. Der Name muss auch dort auflösen, etwa über einen DNS-Server, den du in Tailscale hinterlegst.
Ohne Caddy kannst du zum Testen auch direkt http://192.168.1.50:8000 im Browser öffnen und in Claude Code http://192.168.1.50:8000/mcp eintragen. Dafür muss 192.168.1.50:8000 in MCP_ALLOWED_HOSTS stehen. Der Token geht dann allerdings unverschlüsselt durchs Netz, das ist nur für einen kurzen Test okay. Solange die Regel aus Schritt 8 aktiv ist, klappt das außerdem nur vom Caddy-Host aus.
Schritt 10: Claude Code anbinden
Auf deinem Rechner fügst du den Transcriber als MCP-Server zu Claude Code hinzu. Mit --scope user steht er dir in allen Projekten zur Verfügung, als Token nimmst du den MCP_TOKEN aus der .env:
claude mcp add --transport http --scope user transcriber \
  https://transcribe.example.com/mcp \
  --header "Authorization: Bearer DEIN-MCP-TOKEN"
Der Token steht danach in deiner Shell-History und im Klartext in der Datei ~/.claude.json, in der Claude Code Server mit --scope user speichert. Behandle beides wie ein Passwort. Den Befehl löschst du aus der History, in bash zum Beispiel mit history, das dir die Nummer der Zeile zeigt, und danach mit history -d <nummer>.
Danach kannst du in einer Claude-Code-Session ganz normal schreiben, zum Beispiel „Transkribier dieses TikTok und sag mir, warum der Hook funktioniert“ und den Link dahinter. Claude ruft transcribe_video auf, wartet, bis Transkription und Analyse fertig sind, und arbeitet mit dem Ergebnis weiter. Mit list_transcripts und get_transcript greift Claude auch auf ältere Transkripte zu, so kannst du zum Beispiel zehn Videos eines Creators vergleichen lassen.
Jeder Aufruf über MCP startet standardmäßig auch die Analyse und verbraucht damit API-Guthaben. Willst du nur den Text, schreib in deine Anfrage „ohne Analyse“. Dann setzt Claude den Parameter analyze auf false.
So prüfst du, ob es läuft
docker pszeigt beim Containertranscribernach etwa einer Minute den Status(healthy).- Im LXC liefert
curl http://127.0.0.1:8000/healtheine Antwort mit"ok":true. Steht dort"analysis":trueund"mcp":true, hat die App deinen API-Key und den MCP-Token gefunden. Fehlt curl, installierst du es mitapt install curl. - Einen Test ohne Browser startest du direkt im LXC. Mit
"wait":truewartet der Aufruf, bis das Transkript fertig ist, und gibt es als JSON aus:
curl -s -X POST http://127.0.0.1:8000/api/transcribe \
  -H "Content-Type: application/json" \
-d '{"url":"https://www.tiktok.com/@creator/video/1234567890","wait":true,"analyze":false}'- Im Browser öffnest du
https://transcribe.example.com, fügst einen Link ein und klickst auf „Transkribieren“. Über dem Transkript zeigt die Oberfläche an, wie viele Sekunden der Job gebraucht hat. claude mcp listzeigt den Servertranscriberals „Connected“.- Von einem anderen Rechner im LAN läuft
curl -m 5 http://192.168.1.50:8000/healthin einen Timeout. Dann greift die Regel aus Schritt 8. - Aus einem fremden Netz ohne Tailscale, etwa über mobile Daten, löst der Name entweder gar nicht auf, oder Caddy antwortet mit 403.
Häufige Probleme
TikTok-Transkripte sind leer
Das ist genau der Bug, den ich oben beschrieben habe. Wenn du den Code anpasst oder ein anderes Tool nutzt, achte darauf, bei TikTok nicht die reine Audiospur zu laden. Die enthält oft nur die Musik. Mit dem Code aus diesem Guide passiert das nicht, weil er bei TikTok ein Video mit Ton herunterlädt.
Fehler „no audio downloaded“
yt-dlp hat nichts heruntergeladen. Meist ist das Video länger als 15 Minuten, privat oder gelöscht. Für längere Videos erhöhst du MAX_DURATION_SECONDS in der docker-compose.yml und startest mit docker compose up -d neu. Rechne bei langen Videos mit entsprechend längerer Rechenzeit.
Downloads gehen plötzlich nicht mehr
Die Plattformen ändern regelmäßig etwas, und dann braucht yt-dlp ein Update. Weil yt-dlp in der requirements.txt nicht gepinnt ist, reicht ein Neubau ohne Cache. Deine Transkripte und das Modell bleiben dabei im Ordner data erhalten:
docker compose build --no-cache
docker compose up -d
YouTube-Links scheitern
Laut der yt-dlp-Doku braucht yt-dlp zum Zeitpunkt des Schreibens für volle YouTube-Unterstützung eine JavaScript-Runtime wie Deno. Ergänz die Deno-Zeile im Dockerfile und yt-dlp[default] in der requirements.txt wie in Schritt 3 beschrieben und bau neu wie im Abschnitt darüber.
Instagram-Links scheitern
Instagram verlangt bei vielen Posts die Cookies eines eingeloggten Accounts. yt-dlp kann mit solchen Cookies arbeiten, der Code in diesem Guide gibt aber keine mit. Instagram-Links, die einen Login brauchen, funktionieren damit also nicht.
Die Web-Oberfläche zeigt 401
Du hast API_TOKEN gesetzt. Die Oberfläche schickt keinen Token mit, deshalb lehnt die App jede Anfrage ab. Nimm die Variable aus der .env und starte den Container mit docker compose up -d neu.
Die Analyse fehlt oder zeigt einen Fehler
Ohne ANTHROPIC_API_KEY überspringt die App die Analyse einfach. Ist der Key gesetzt, aber falsch, oder ist dein API-Guthaben aufgebraucht, zeigt die Oberfläche den Fehler im Analyse-Kasten an. Das Transkript bleibt in beiden Fällen nutzbar. Hast du das Problem behoben, klickst du auf „Neu analysieren“.
Claude Code meldet „Failed to connect“
claude mcp get transcriber zeigt dir den Grund. Bei 401 stimmt der Token nicht mit MCP_TOKEN in der .env überein, oder MCP_TOKEN ist leer. Bei 404 fehlt am Ende der URL /mcp. Bei 403 kommt dein Rechner nicht aus einem erlaubten Netz, dann prüfst du, ob Tailscale läuft.
Mit curl siehst du schnell, wo es hakt. curl -i https://transcribe.example.com/mcp ohne Token sollte 401 liefern. Dann ist die App über Caddy erreichbar, und das Problem liegt beim Token. 421 heißt, dass der Hostname nicht in MCP_ALLOWED_HOSTS steht. Nutzt du in Caddy tls internal, hängst du --cacert root.crt an, also das Root-Zertifikat von Caddy. Claude Code vertraut dieser CA nur, wenn es sie im Zertifikatsspeicher deines Betriebssystems findet. Das klappt mit dem nativen Installer oder bei einer npm-Installation ab Node 22.15. Sonst gibst du sie per NODE_EXTRA_CA_CERTS=/pfad/zu/root.crt an. Details stehen im Guide zu sicheren MCP-Servern.
Claude Code meldet 421 oder „Misdirected Request“
Der Name, unter dem du /mcp aufrufst, steht nicht in MCP_ALLOWED_HOSTS. Trag ihn in der .env ein und führ danach docker compose up -d aus. Ein docker compose restart reicht dafür nicht, weil er geänderte Umgebungsvariablen laut Docker-Doku nicht übernimmt. up -d erstellt den Container dagegen mit der neuen Konfiguration neu.
Der Container stürzt ab oder ist sehr langsam
Prüf in Proxmox die RAM-Auslastung des LXC. Mit 8 GB läuft medium bei mir ohne Probleme. Hast du weniger Kerne oder RAM, stell WHISPER_MODEL auf small und WHISPER_THREADS auf die Zahl deiner Kerne. Das Ergebnis ist dann etwas ungenauer, aber schneller.
Fazit
Für mich ist der Transcriber vor allem ein Recherche-Tool: Ich schaue mir an, wie andere Homelab- und Tech-Creator ihre Videos aufbauen, und lerne daraus für meine eigenen. Die Transkription läuft lokal und kostenlos, und über MCP fragst du Claude einfach in normaler Sprache danach.
Wofür würdest du so einen Transcriber nutzen? Schreib es mir in die Kommentare.
Hat dir der Guide geholfen? Dann spendier mir gern einen Kaffee auf Ko-fi. Damit bleibt MappleBox werbefrei.