Paperless-ngx 3 mit Claude: Dokumente automatisch sortieren, ohne Tag-Chaos
Paperless-ngx läuft bei mir schon länger, und eigentlich sollte es auch für meine Mutter funktionieren: Brief scannen, fertig, den Rest macht das System. Damit das Sortieren nicht an mir hängen bleibt, hatte ich vor einiger Zeit das externe Add-on paperless-ai mit GPT-4o-mini an Paperless 2.15.3 gehängt. Das Add-on hat fleißig getaggt, und zwar mit allem, was ihm gerade eingefallen ist. Am Ende hatte ich 923 Tags, 129 Dokumenttypen und 424 Korrespondenten. Suchen konnte man darin nichts mehr.
Paperless-ngx 3 bringt jetzt eine eigene KI-Integration mit. In diesem Artikel zeige ich, wie ich aufgeräumt, upgegradet und die KI mit Claude so eingerichtet habe, dass sie nur noch mit meinen Tags arbeitet.
Schritt 1: Export als Rollback-Punkt
Bevor ich irgendetwas gelöscht oder zusammengelegt habe, kam ein kompletter Export. Paperless bringt dafür den document_exporter mit. Der Export enthält die Originale, die archivierten PDFs und alle Metadaten, und lässt sich später wieder in eine leere Instanz importieren.
cd /opt/paperless
docker compose exec webserver document_exporter ../export
Wenn beim Aufräumen etwas schiefgeht, komme ich mit diesem Export jederzeit auf den alten Stand zurück.
Schritt 2: Die Taxonomie neu aufbauen
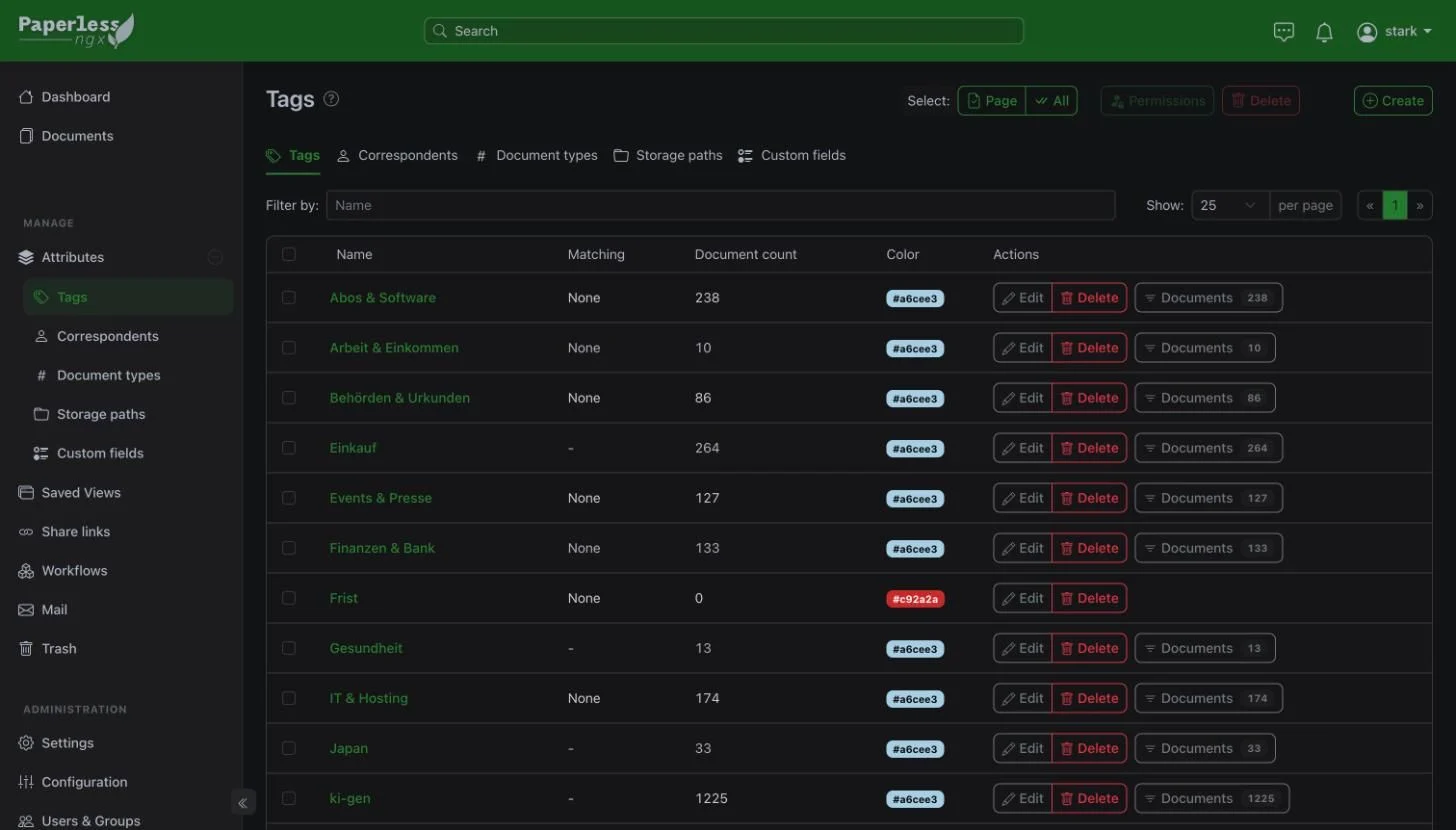
Statt die 923 Tags einzeln durchzugehen, habe ich mir überlegt, welche Struktur ich eigentlich haben will, und dann alles darauf gemappt. Übrig geblieben sind:
| Vorher | Nachher | |
|---|---|---|
| Tags | 923 | 17 Bereichs-Tags plus „Neu“ und „Frist“ |
| Dokumenttypen | 129 | 16 |
| Korrespondenten | 424 | 226 |
Die Bereichs-Tags decken grobe Lebensbereiche ab. „Neu“ ist mein Inbox-Tag: Alles, was reinkommt, bekommt es, und ich nehme es weg, sobald ich das Dokument angeschaut habe. „Frist“ markiert alles, wo ich noch etwas tun muss. Bei den Korrespondenten habe ich Duplikate zusammengelegt und alles gelöscht, was keinem Dokument mehr zugeordnet war.
Schritt 3: Der Upgrade-Pfad auf 3.3.0
Ich wollte bei der Gelegenheit auch eine saubere Installation mit Docker Compose. Deshalb lief das Upgrade in mehreren Etappen:
- Export aus der alten Instanz (siehe oben)
- Frische Paperless-Instanz 2.15.3 per Docker Compose aufsetzen und den Export importieren
- Update auf 2.20.15
- Update auf 3.3.0
Der Import in die frische Instanz geht mit dem Gegenstück zum Exporter:
docker compose exec webserver document_importer ../exportNeben Paperless laufen im Compose-Stack Apache Tika und Gotenberg 8 für Office-Dokumente und Mails. Tika habe ich auf Version 3.3.1.0 gepinnt, weil Tika 4 bei mir Paperless kaputt gemacht hat. Der relevante Auszug aus der docker-compose.yml:
services:
  webserver:
    image: ghcr.io/paperless-ngx/paperless-ngx:3.3.0
  gotenberg:
    image: gotenberg/gotenberg:8
  tika:
    image: apache/tika:3.3.1.0
Für die OCR sind Deutsch, Französisch und Englisch eingestellt.
Schritt 4: Die eingebaute KI mit Claude
Paperless 3.x kann ein LLM direkt ansprechen, ein Add-on brauchst du dafür nicht mehr. Ich nutze das OpenAI-kompatible Backend und lasse es auf den OpenAI-kompatiblen Endpoint von Anthropic zeigen:
https://api.anthropic.com/v1/Als Modell läuft Claude Haiku. In der Konfiguration trägst du dafür Backend-Typ, Endpoint-URL, deinen Anthropic-API-Key und den Modellnamen ein.
Beim ersten Test kam nur ein Fehler zurück. Haiku lehnt den Parameter temperature ab, den Paperless mitschickt. Der Fix ist eine Zeile im Environment des Paperless-Containers:
PAPERLESS_AI_LLM_EXTRA_PARAMS={"temperature": null}Damit wird der Parameter nicht mehr gesetzt, und die Anfragen gehen durch.
Die Embeddings für die semantische Suche und für ähnliche Dokumente laufen lokal. Ich nutze dafür das mehrsprachige Modell paraphrase-multilingual-MiniLM-L12-v2, weil meine Dokumente eben nicht nur Englisch sind. Für die Embeddings verlässt also nichts den Server, nur die Klassifizierung geht an Claude.
Schritt 5: Ein Workflow, der keine neuen Tags erfindet
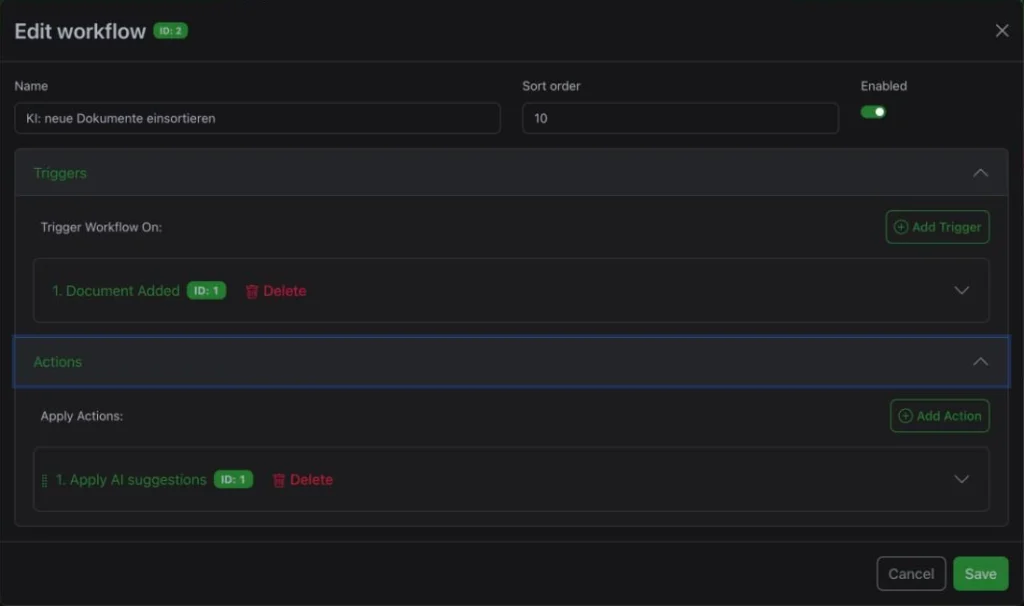
Den Unterschied zum alten Chaos macht der Workflow. Er hängt am Trigger „Document Added“ und lässt die KI vier Dinge setzen: Titel, Tags, Korrespondent und Dokumenttyp. Die zwei Einstellungen, auf die es ankommt:
- „Create missing“ ist AUS. Die KI darf nur aus den vorhandenen Tags, Typen und Korrespondenten wählen und legt nichts Neues an. Genau das hat paperless-ai damals gemacht.
- Overwrite ist AN, damit die KI auch Felder setzen darf, die beim Import schon einen Wert bekommen haben.
Danach habe ich die 166 vorhandenen Dokumente einmal nachträglich durch die KI laufen lassen, damit auch der Altbestand zur neuen Struktur passt.
Pitfall: RAM beim Backfill
Ich habe den Neuaufbau des KI-Index und den Backfill gleichzeitig gestartet. Mit 6 GB RAM ist der Container dabei an Out of Memory gestorben. Seitdem hat er 12 GB, und die beiden Jobs laufen bei mir nie mehr parallel: erst den Index fertig bauen lassen, dann den Backfill starten.
Kosten und Backup
Für Paperless habe ich einen eigenen API-Key angelegt und in der Anthropic-Console ein Spending-Limit von 5 Dollar gesetzt. Falls ein Workflow mal in einer Schleife hängt, ist der Schaden damit begrenzt.
Der Export aus Schritt 1 läuft inzwischen jede Woche per Cron. Ein Eintrag in der Crontab des Hosts reicht, zum Beispiel sonntags um 3 Uhr:
0 3 * * 0 cd /opt/paperless && docker compose exec -T webserver document_exporter ../exportDas -T ist wichtig, weil Cron kein Terminal hat und docker compose exec sonst abbricht.
Familientauglich machen
Meine Mutter soll Paperless benutzen können, ohne mich anzurufen. Sie hat einen eigenen User ohne Admin-Rechte, damit sie nicht aus Versehen Tags löscht oder Workflows ändert. Die Oberfläche steht bei ihr auf Deutsch. Durch die Inbox mit „Neu“ sieht sie sofort, was frisch reingekommen ist.
Als Nächstes kommt ein Dokumentenscanner mit Scan-to-Folder per SMB. Der Scanner legt die PDFs dann direkt in den Consume-Ordner von Paperless, und den Rest erledigt der Workflow.
Wenn du Paperless erst aufsetzen willst und noch keinen Server hast: Ein Mini-PC* reicht dafür, solange du ihm genug RAM für die KI-Jobs gibst.
Fazit
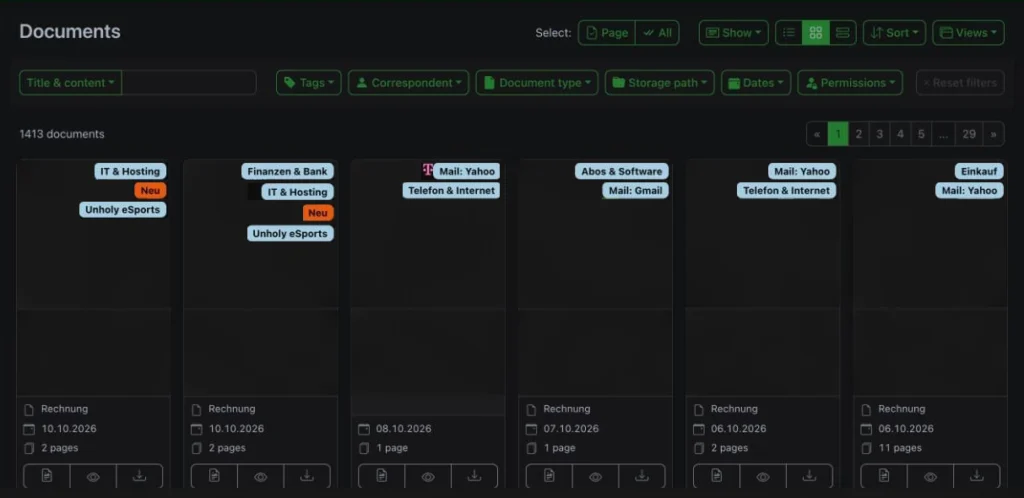
Weil „Create missing“ aus ist, bleibt es bei den 17 Bereichs-Tags plus „Neu“ und „Frist“. Neue Dokumente landen mit Titel, Typ und Korrespondent in der Inbox, und ich entferne nur noch „Neu“, wenn ich sie durchgesehen habe.
Nutzt du die KI in Paperless schon, und mit welchem Modell? Schreib es in die Kommentare.
* Affiliate-Link: Als Amazon-Partner verdiene ich an qualifizierten Verkäufen. Für dich ändert sich am Preis nichts. Mehr dazu